一、它是啥:不露脸、不开剪辑软件,画面每一笔都是代码画出来的
whiteboard-video 是 GitHub 仓库 trustfuture/simon-skills 合集里的一支「手绘白板讲解视频 skill」。给 AI 一句选题,它会自己查资料、写旁白、用 rough.js 画一整套手绘白板场景、用火山引擎 TTS 配音并逐字对齐字幕、再用 Playwright 无头浏览器逐笔渲染(铅笔跟着笔尖走,4 路并行)、自动混配乐——最后交回一份 1080p 成片 + 横竖两张封面 + 带 5 个候选标题的发布稿。全程不露脸、不打开任何剪辑软件,画面里每一根线条、每一个框、每一个字,都是代码一笔一笔"画"出来的。
先按数据红线实查(2026-10-05 查):★262 / fork 57 / MIT / JavaScript / 约 41.9MB / 09-20 建、09-24 还在推(活跃),默认分支 master,仓库 topics 直接挂了 excalidraw、remotion、claude-code、codex。它是个「不露脸做视频账号」的 AI skill 合集,白名单里有三支:investigation-video(调查长片)、video-common(公共工序)、和本文主角 whiteboard-video(手绘白板讲解)。下面几节全是只有 clone 下来读 lib/、SKILL.md、references/ 才写得出的机制,不是照 README 念一遍。
二、全链路:一句选题 → 1080p 成片 + 双封面 + 发布稿,本地闭环
整个 skill 是一条全本地的流水线,工具就是仓库本身,CLI 是 bin/wb,参数全在 config.json。核心命令就 8 个:
$W new  "标题"     # 建期目录:scenes.js 模板 + 发布.md 模板
$W logo "标题" ... # 真实 Logo(走 Wikimedia Commons 官方 SVG)→ 贴纸
$W image "标题" ... # 白板贴纸(本地 codex CLI 生图,一次 ≤4 张)
$W stills "标题"   # 每 beat 静帧,逐张看排版
$W cover "标题"    # 封面-4x3.png + 封面-3x4.png(横竖两张)
$W build "标题"    # scenes→tts→render→mix→cover→clean 一条龙,出 final.mp4
关键点:画面每一笔都是代码画的——旁白走火山引擎 TTS(凭证在 .env),贴纸走本地 codex CLI 生图,真实 Logo 走 Wikimedia Commons,渲染走 Playwright + ffmpeg,配乐丢进 assets/bgm.mp3。整个链路不需要任何剪辑软件,也不露脸,人只需要写 scenes.js 一个文件(旁白、场景、封面全在里面)。scenes/、旁白稿.md、字幕.srt、封面-*.png 都是生成物,不手改。
SKILL.md 里写得很直白的一串"硬规矩"我印象最深:「全链路本地」「一处为主(scenes.js 是唯一手写源)」「先旁白后画面」「画布 1920×1080,y≥960 是字幕区」「事实先查再写」「交付四件套:成片 + 两张封面 + 发布.md」。这就是它"给一句选题就能出片"的底气。
三、逐笔渲染的机制:rough.js 双描边拆 A/B + 每帧整屏重插
它最巧的地方在 lib/render.html。Excalidraw 的"手绘感"来自 rough.js,而 rough.js 默认每条边会描两遍(multi-stroke),如果整条 path 一起用 dashoffset 顺序描,视觉上就是"同一个框飞快画两次"。渲染器把这个拆成了 A/B 两层:
// A 层跟笔尖走,B 层滞后一点点同步浮现 → 一遍画完、线条有手绘的双线质感
const paired = !isFillStroke && subs.length >= 2 && subs.length % 2 === 0;
for (let i = 0; i < subs.length; i += paired ? 2 : 1) {
  const node  = strokeNode(subs[i], p);   g.appendChild(node);
  let nodeB = null;
  if (paired) { nodeB = strokeNode(subs[i + 1], p); nodeB.style.opacity = 0; g.appendChild(nodeB); }
}第二个"暗功夫"是每帧强制整屏重画。Chromium 默认只重画"变了的区域",铅笔附近的抗锯齿会带上一帧的痕迹,帧就跟出帧顺序有关了——这在并行渲染时是致命的。渲染器在 seek(t) 里把底色矩形原地重插一次,等于整屏失效,让每一帧只由 t 决定:
window.seek = function (t) {
  bg1.parentNode.insertBefore(bg1, bg1.nextSibling);   // 底色矩形原地重插 = 整屏失效
  updateCaption(t);                                      // 烧录字幕
  for (const b of items) { const tp = progressItem(b, (t - b.start) / (b.end - b.start)); if (tp) tip = tp; }
  if (!tip) tip = travelTip(items, t);                  // 铅笔在抬笔间隙里的移动
  if (tip) pen.setAttribute('transform', `translate(${tip[0].toFixed(1)},${tip[1].toFixed(1)})`);
}
这两点叠加,才敢开 4 路并行。SKILL.md 的"已知坑"里记了一组实测:同一个 Chromium 里开 4 个页面,截图会卡在浏览器主进程,实测只有约 113 帧/秒;各开各的独立 Chromium 才真正并行,4 路约 180 帧/秒。而且出帧和路数无关、逐字节一致——因为它保证 seek(t) 纯由 t 决定。所以"2.5 分钟的片 35 秒渲完(4 路并行)"这句话,在 render.html + config.json(render.workers=4)里是站得住的,不是宣传。
字幕为什么能"逐字对":lib/tts-volc.mjs 拿到火山 TTS 返回的 words(每个词带 startTime/endTime),累加出每段旁白的起始秒 segStarts,再写进 audio/<scene>.json 交给渲染器——画图节奏和配音是同一套时间轴,字幕 cues 也从这里来,改旁白必须重跑 tts。
四、我本地真跑了一遍(免凭证段):scenes → cover → stills
clone 下来 npm install(装上 roughjs + playwright + lz-string),然后走通了它不依赖火山 key、不依赖 codex 贴纸、不依赖 ffmpeg的那一段:scenes(纯 Node 跑 DSL)→ cover(rough.js + 无头 Chromium)→ stills(逐 beat 静帧)。
第一步 wb scenes:把 scenes.js 跑成 Excalidraw 文件——每支场景一个 .excalidraw.md(正是 Obsidian 的 Excalidraw 插件格式,也就是"场景图能直接在 Obsidian 里改"的出处),外加渲染器用的 script.json 和自动生成的《旁白稿.md》:
$ wb scenes "演示白板片"
01-intro: 3 beats, 16 elements
02-body:  3 beats, 8 elements
03-outro: 2 beats, 5 elements
00-cover-4x3: 封面 1440×1080, 10 elements
00-cover-3x4: 封面 1080×1440, 10 elements
生成的 .excalidraw.md 长这样(节选)——带 Obsidian 前置块、Text Elements、Embedded Files 和 json 压缩块:
---
excalidraw-plugin: parsed
tags: [excalidraw]
---
## Text Elements
01-intro ^el000010
...
## Drawing
```json
{ "type":"excalidraw","version":2,"source":"grok-bot-video", ... }
```
第二步 wb cover:rough.js 手绘出横竖两张封面(4:3 给公众号/横版,3:4 给视频号竖版/小红书):
$ wb cover "演示白板片"
封面 4:3 1440×1080 → 封面-4x3.png
封面 3:4 1080×1440 → 封面-3x4.png
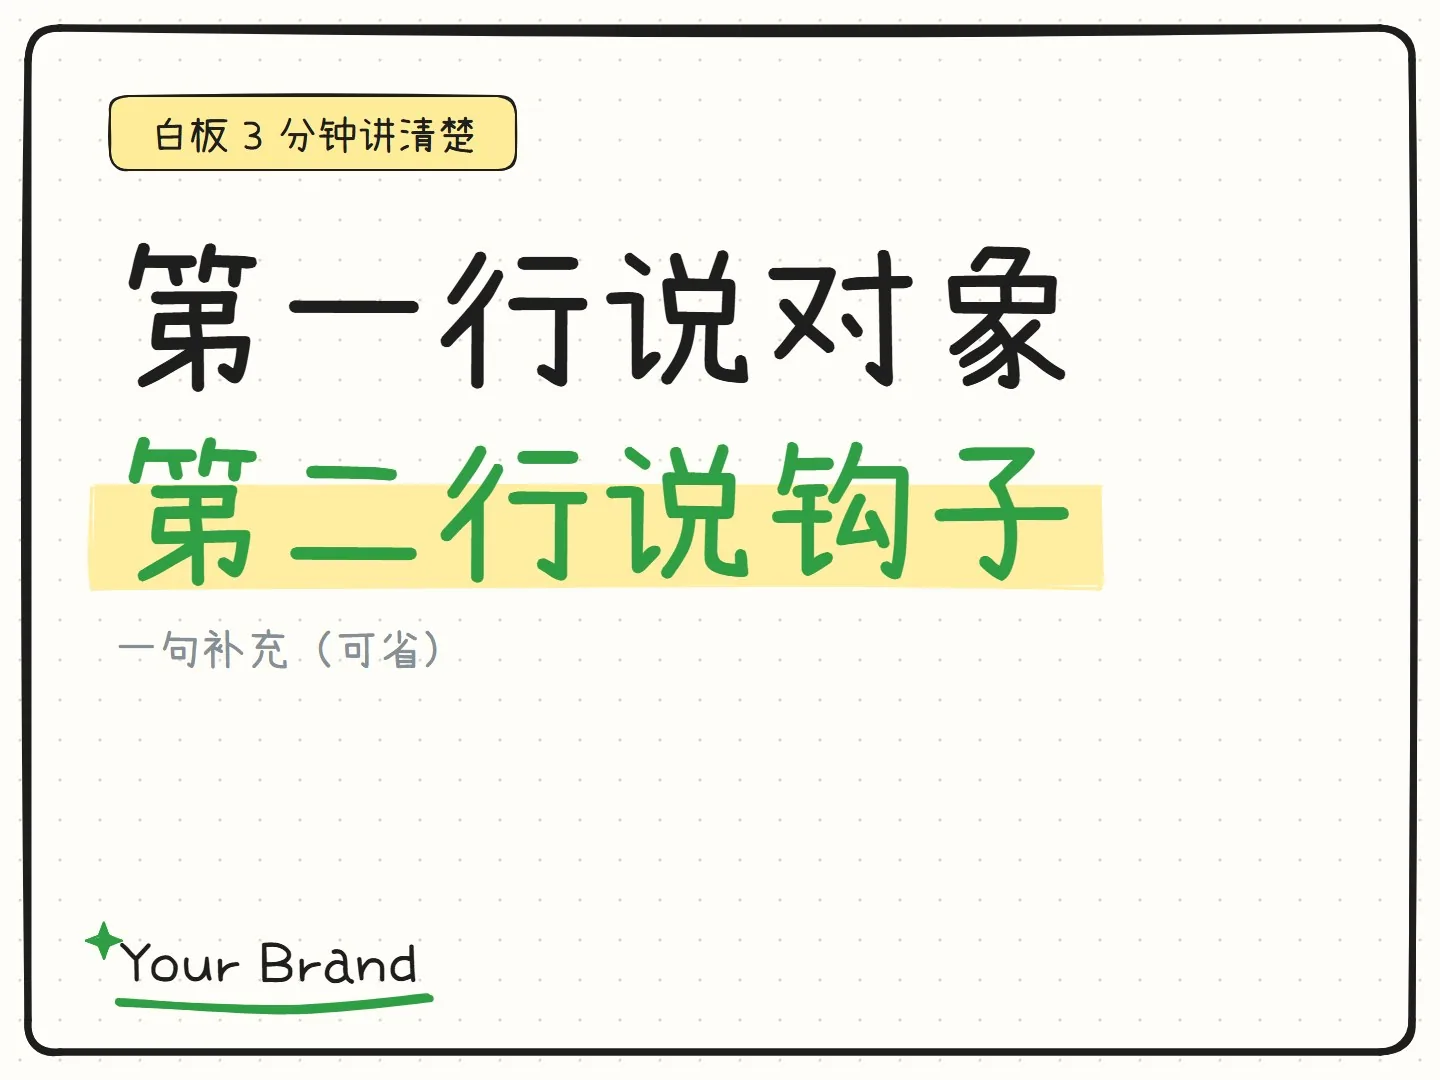
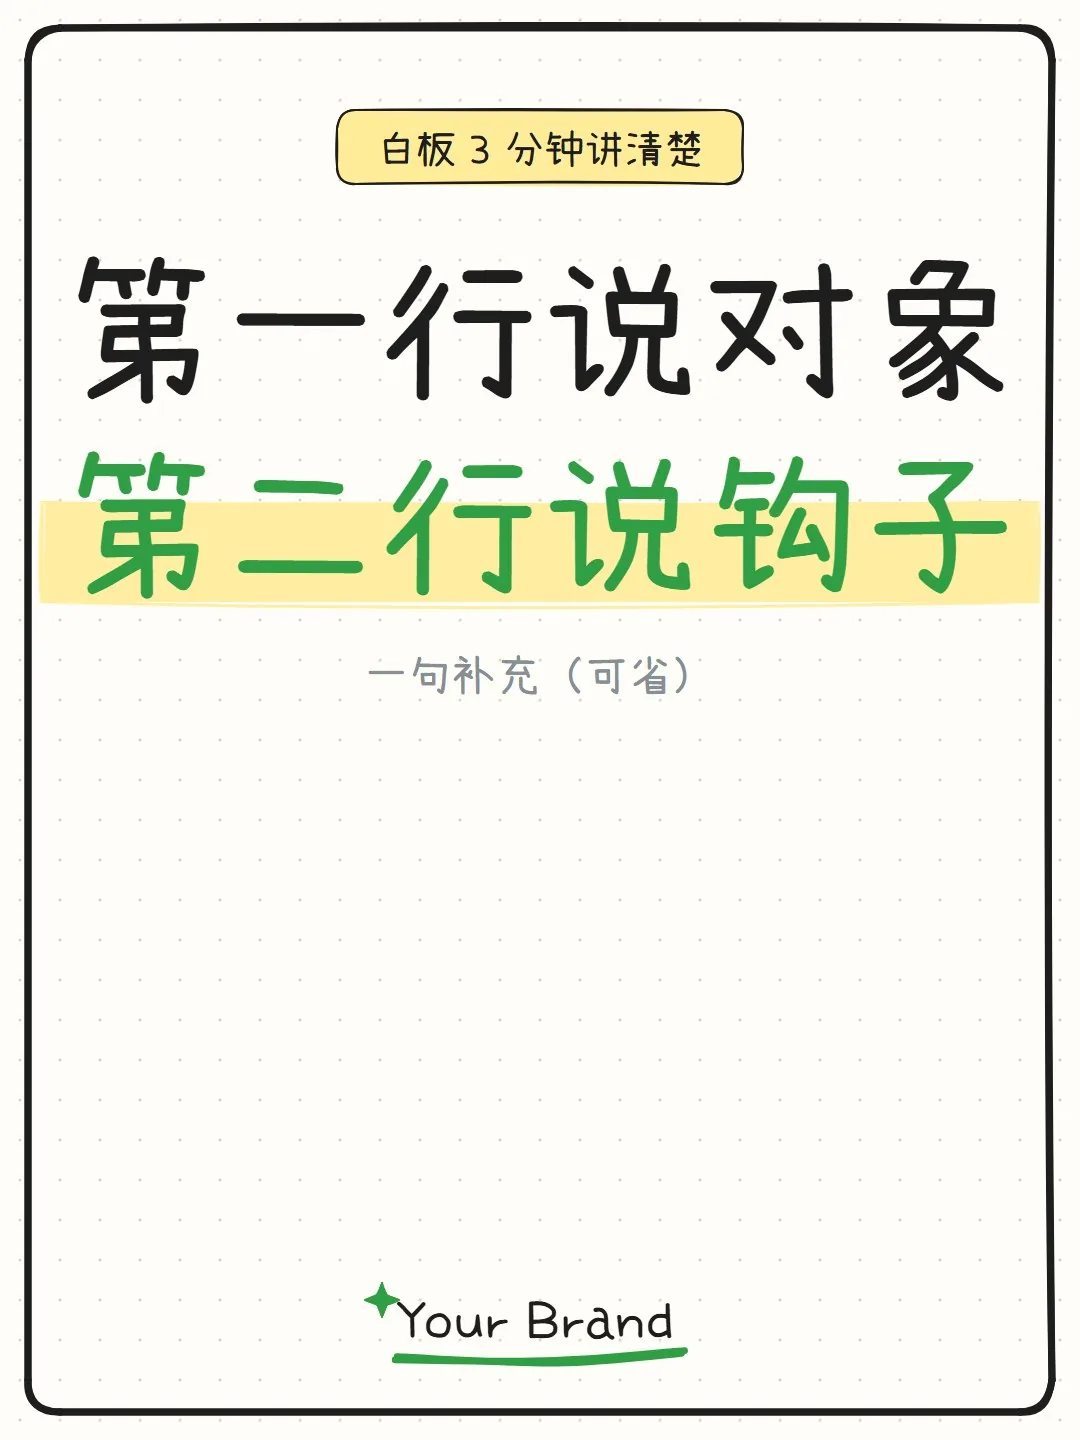
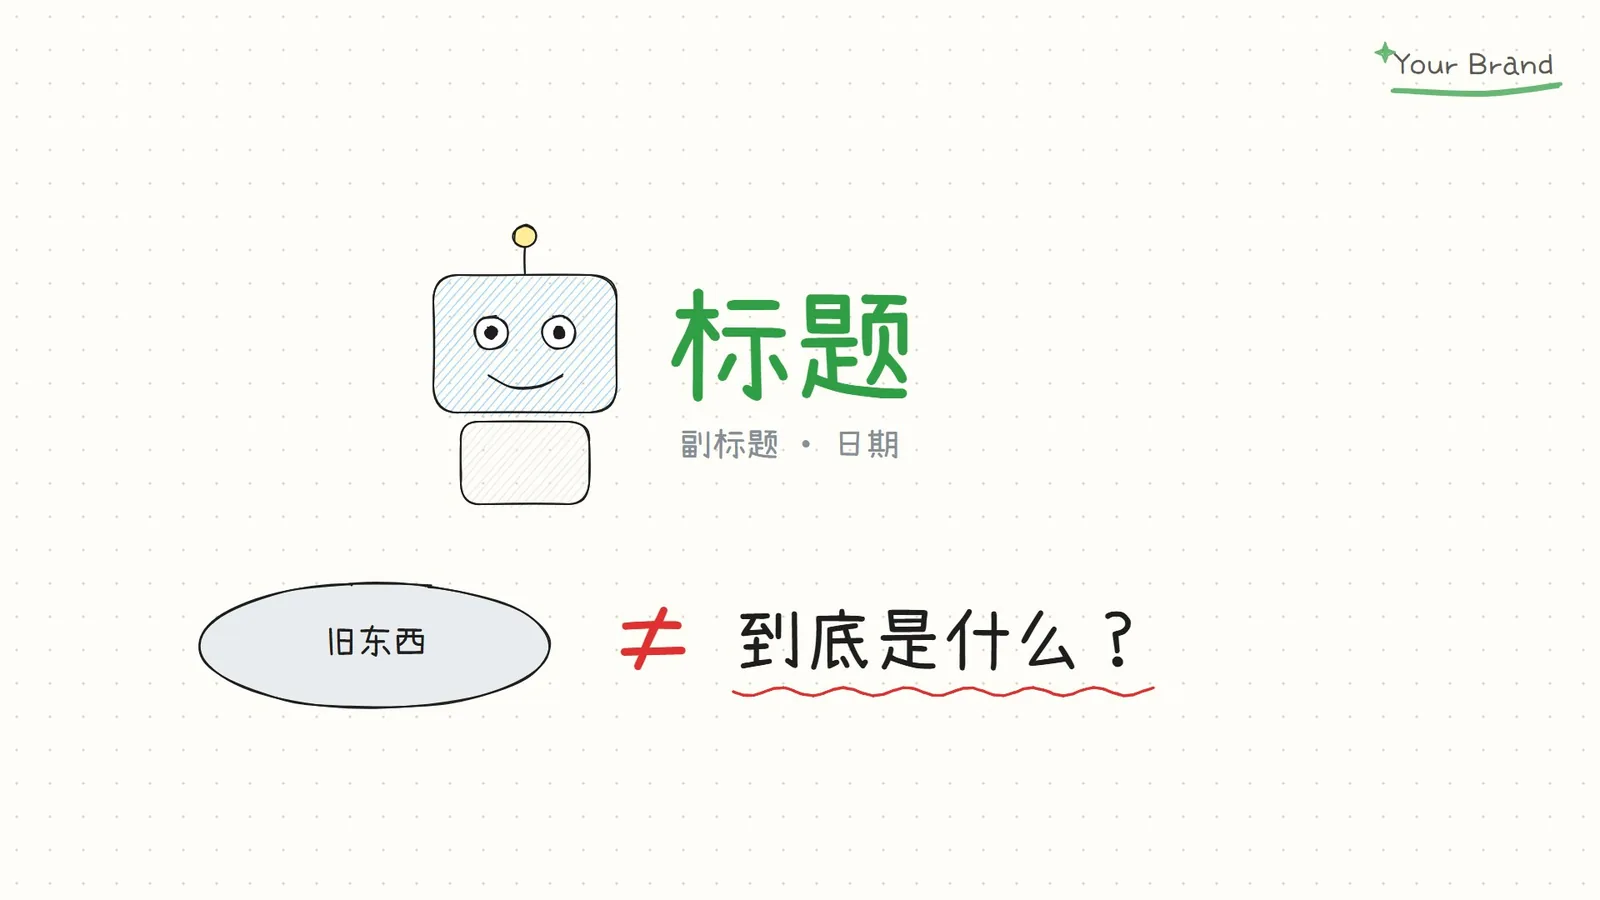
第三步 wb stills:把每个 beat 画到"这一笔结束"的静帧导出来逐张看排版(这是它"边画边讲"逐笔节奏的直观证据,铅笔停在每一笔末端):
$ wb stills "演示白板片"
01-intro: 16 items, 3 stills
02-body:  8 items, 3 stills
03-outro: 5 items, 2 stills
99-brand: 6 items, 1 stills
五、横向对比:它和别的"白板/出片"路线差在哪
| 路线 | 它给什么 | 强 | 何时别用 |
|---|---|---|---|
| whiteboard-video(本文) | 手绘白板逐笔讲解:rough.js+Excalidraw 场景、火山 TTS 逐字对字幕、4 路并行渲染、双封面 + 发布稿 | 「边画边讲」科普/讲道理类视频,画面全代码、可复现、MIT 可商用;场景图能在 Obsidian 改 | 要真人出镜、要实拍、或画面要靠复杂贴纸/Logo 堆量时,得另外 wb image/wb logo 补素材 |
| adu-motion-video(上一篇) | 选模板×风格,把剪好的口播交给 AI 剪成 60fps 成片,带 11,028 个 Lottie 素材 | 「口播 → 成片 + 可编辑工程」,模板编舞冻结省 Token | 不做手绘白板逐笔讲解,画面靠 Lottie 素材不是代码手画 |
| 传统剪辑软件(剪映/PR) | 时间线拖素材、卡点、转场 | 素材驱动、自由度高、上手直观 | 画面全靠拖素材,不是"代码画出来";逐笔动画做不了 |
| 白板协作工具(Miro/Excalidraw 网页) | 在线协作画图 | 多人实时协作、即时 | 不能自动配音、逐笔渲染、出 1080p 成片 + 发布稿,只做"画板"不做"片子" |
六、坑与边界 + 我的判断
- 完整
build我这次没跑全,是刻意的:它默认要火山 TTS 凭证(.env的VOLC_TTS_VOICE)、贴纸要本地codexCLI 生图、出片要ffmpeg。我实跑的是免凭证段(scenes/cover/stills)——这一段能验证"手绘逐笔 + 双封面 + Excalidraw 底层"这些核心卖点,不碰任何 key。完整出final.mp4还得把这三样补齐。 - 平台差异坑:它
bin/wb用$(dirname ...)算路径,在 macOS/Linux 原生没问题,但我在 Git Bash(Windows)下跑会把__WB_ROOT__填成/c/Users/...的 POSIX 前缀,Node 解析不了——得把生成物里的前缀手改成C:/正斜杠。macOS/Linux 上无此坑。 - 渲染器的两条"别动"红线(它自己在 SKILL.md 里标了):每帧
seek()必须整屏重插底色矩形、每路必须单开 Chromium;改完要用render.workers=1和4各出一遍,ffmpeg -f framemd5对比必须 0 帧不同。动了这俩,4 路并行就出帧不一致了。 - 它管"画 + 讲 + 配 + 出片",不管"选题准不准":SKILL.md 里「事实先查再写」是硬规矩,数字/日期/价格要写进
README.md来源、估算值标"据报道/估算",但查证质量取决于喂给 Agent 的选题本身。
我的判断:这是一个把"白板式科普视频"整条流水线固化成 AI skill 的成熟工程——从"给一句选题"到"1080p 成片 + 双封面 + 五标题发布稿",画面每一笔可复现、可 git diff、场景图还能在 Obsidian 里直接改(因为底层就是 Excalidraw 文件)。它和上一篇 adu-motion-video 正好互补:一个"代码手画逐笔讲道理"(白板),一个"选模板套口播出快片"(Lottie)。真正拉开差距的是它把渲染并行度、逐帧一致性、验收门禁当成工程细节写进了 render.html 和 SKILL.md,不是 demo 级玩具,是能直接跑一个"不露脸知识账号"的生产工具。如果你做的是需要"一步步画出来解释"的科普/教学类内容,这种白板 skill 比通用剪辑更适合交给 Agent 代劳。